 JaviTech
Gastó 300 $ en un mes por los límites de Claude: ahora su GPU hace el primer borrador y ahorra un 43 %
10 de noviembre de 2026 · IA local y LLM
Si usas Claude para programar, sabes perfectamente de qué va esto: te pones a tope, entras en el flujo… y de repente el límite de cinco horas te corta en seco. Al autor de este experimento le pasó tantas veces que acabó soltando más de 300 $ en créditos de uso en un solo mes, encima de su plan Pro de 20 $.
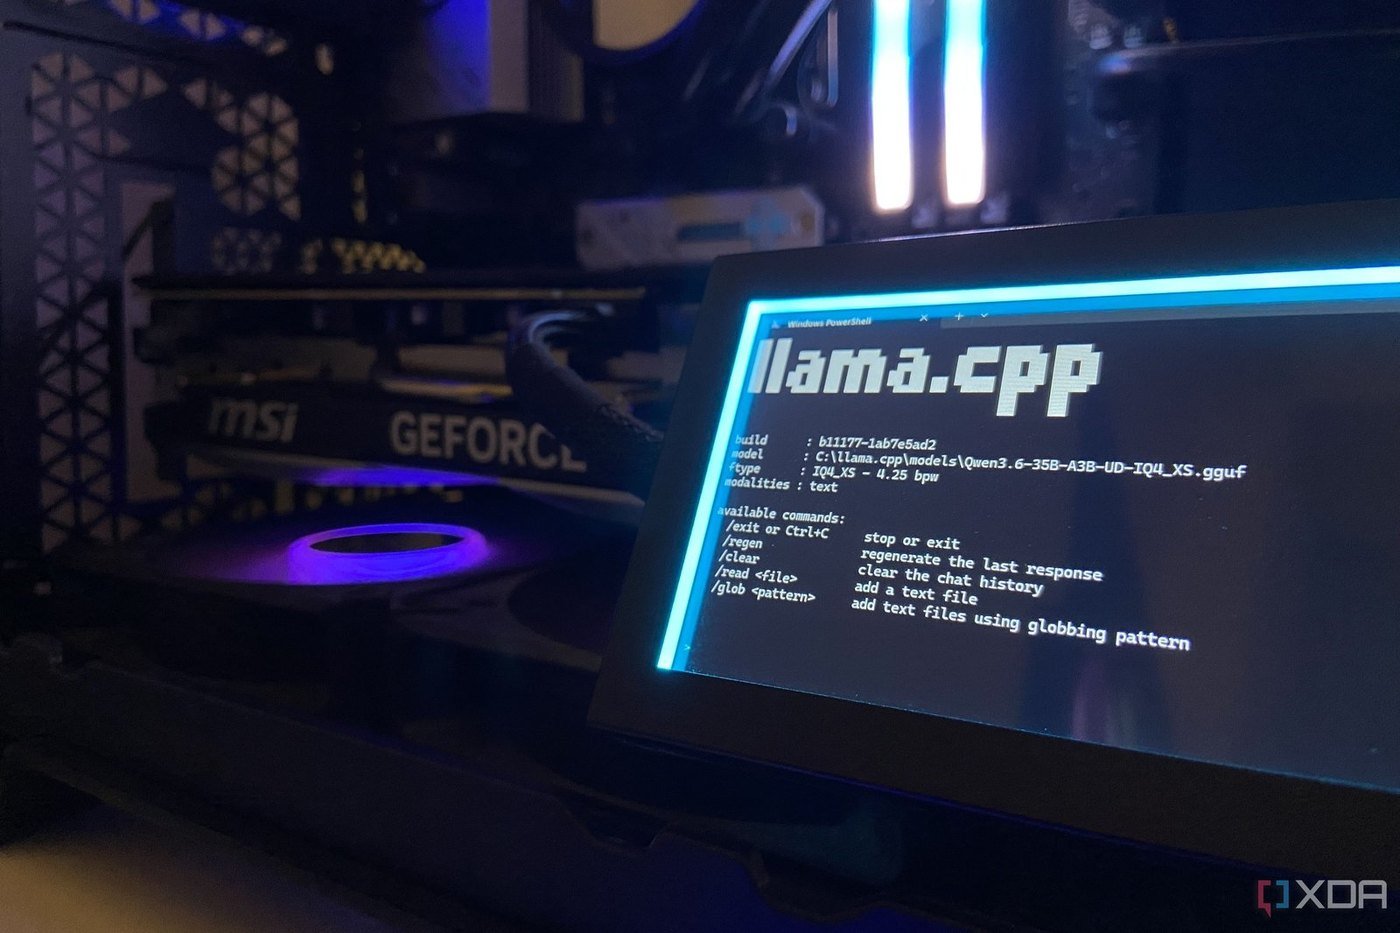
Su solución no fue cambiar de herramienta, sino poner un portero local delante: un Qwen3.6-35B-A3B corriendo en su RTX 4070 Ti Super con llama-server. El coste real, contando solo la luz, le sale a unos 15 céntimos por millón de tokens.
El truco está en repartir el trabajo. La GPU local monta la primera versión (estructura de archivos, bucle principal, clases y lo justo para que arranque) y solo después Claude Code entra a pulir y revisar. En un clon de Asteroids, refinar esa base le costó 0,77 $ frente a los 1,35 $ que costaba si Claude lo hacía todo desde cero: un 43 % menos.
¿Quieres probarlo? Necesitas llama.cpp con la build CUDA y tus archivos GGUF. Si la línea de comandos te da pereza, LM Studio u Ollama hacen lo mismo con un par de clics.
No va de elegir entre local y nube: va de dejar de pagar la nube para lo que tu gráfica ya hace de sobra.
📰 Vía @Fuente: https://www.xda-developers.com/i-spent-300-in-one-month-trying-to-get-past-claudes-rate-limits-so-i-let-my-gpu-do-the-coding-first-instead/
#TIP #IA #Claude #GPU #llamaCpp #Productividad #JaviTech