 JaviTech
No hace falta cambiar de gráfica: cinco modelos pequeños que exprimen 8 GB de VRAM
17 de noviembre de 2026 · Privacidad y seguridad
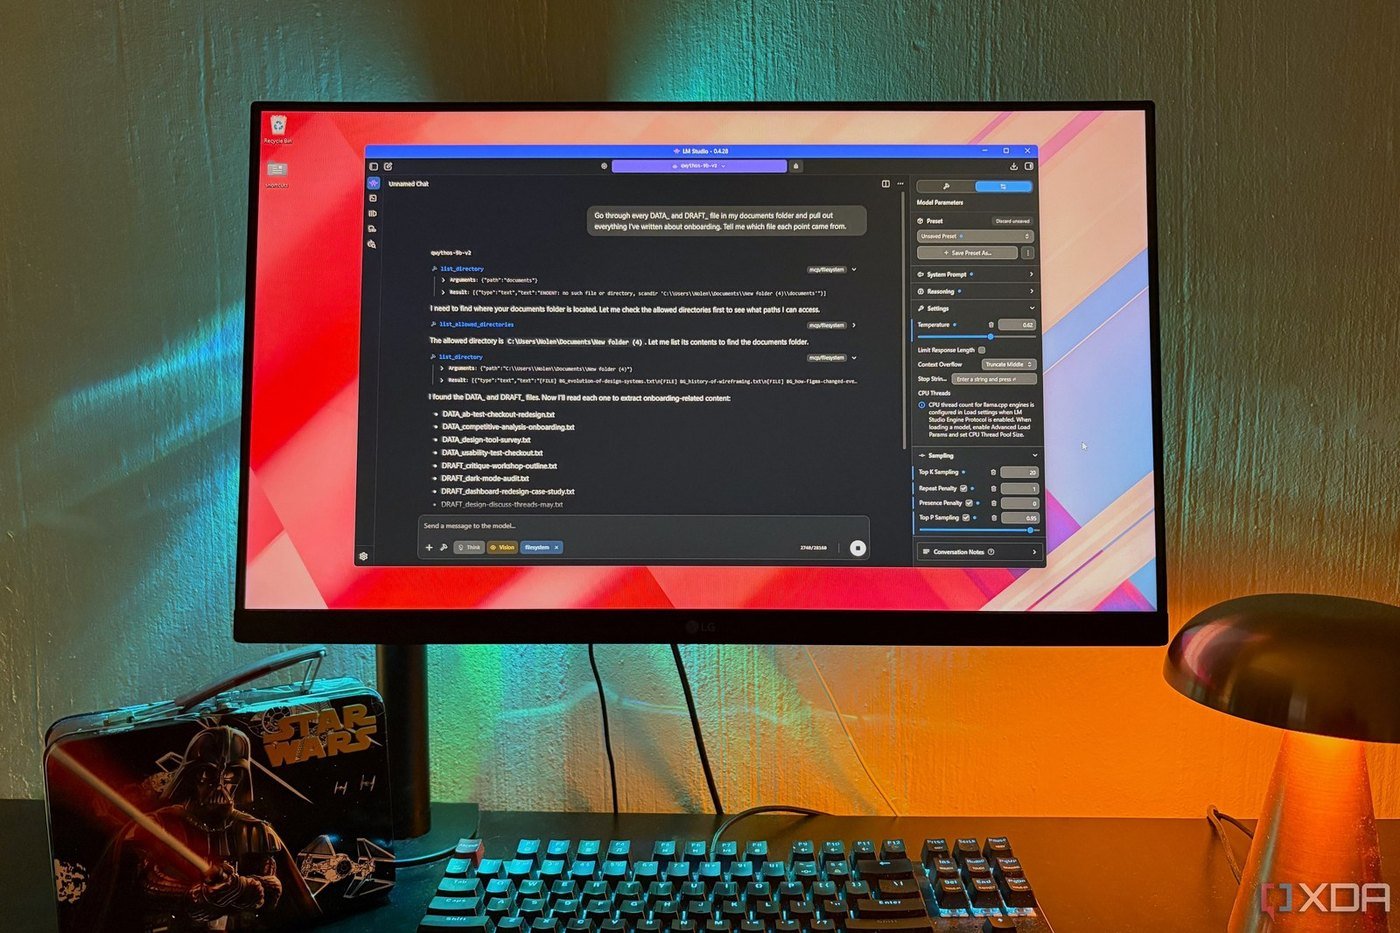
Todo el mundo repite que con 8 GB de VRAM no se puede hacer nada serio con IA local. Un redactor de XDA lleva meses demostrando lo contrario sin rascarse el bolsillo. 🖥️
Su uso no es montar el próximo ChatGPT en casa: es todo lo que NO quiere mandar a un centro de datos. Contratos, papeles legales, documentos financieros e informes de salud. Para eso, un modelo pequeño bien elegido basta.
Los que le están salvando la tarjeta:
🧠 Gemma E4B (el pequeño de Google): saca un 69,4% en MMLU Pro frente al 85,2% del modelo de 31B. Suficiente para el día a día, pero verifica los datos. Llama sin problemas a sus MCP de web y de sistema de archivos.
📄 Un modelo con visión: en vez de copiar y pegar medio documento, le haces una captura y ya. Ideal para resumir contratos o informes médicos que no hay quien entienda.
🧮 DeepSeek-R1-Distill-Llama-8B (enero de 2025): razona en voz alta antes de responder. Perfecto para cuentas de presupuesto y cualquier cosa con números de por medio.
🛠️ Qwen3-Coder-4B, el fine-tune de Project Fluently: en Q4_K_M ocupa solo 2,38 GB y sirve para montar tus propias herramientas sin escribir una línea de código, o para limpiar el YAML de Obsidian.
Su conclusión es la que comparto: la clave no es la tarjeta más grande, sino tener la pila de modelos adecuada a lo que haces. Y todo corre en tu equipo, sin enviar nada a ningún sitio.
¿Usas IA en local o sigues pasándolo todo por la nube? 👇
#IALocal #LLM #GPU #Privacidad #Productividad #JaviTech
📰 Vía @XDA: https://www.xda-developers.com/small-local-models-save-8gb-gpu-from-upgrade/