 JaviTech
Tu agente de IA local se queda sin contexto: estos ajustes lo arreglan
27 de septiembre de 2026 · Almacenamiento y NAS
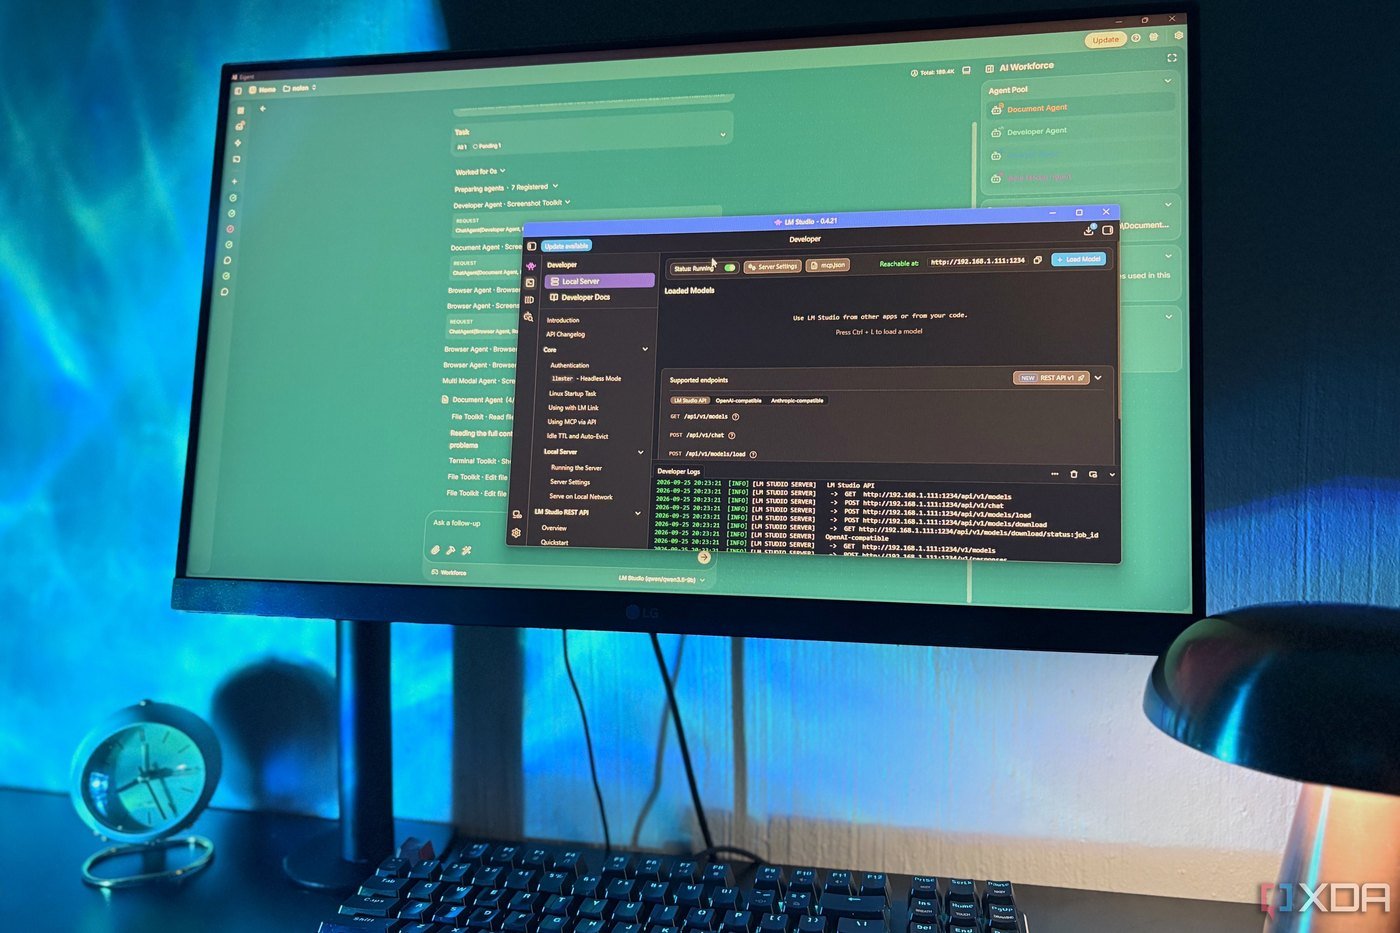
🛠️ Tienes un modelo de IA corriendo en tu propio PC y, a la primera tarea seria, se queda sin contexto. ¿Te suena? Casi nunca es culpa del modelo: es de la configuración.
Desde XDA lo vivieron con Eigent, un agente de código abierto conectado a LM Studio. Le pidieron un trabajo de varios pasos y todos los subtemas volvieron con «Context size has been exceeded».
El motivo: los runners locales traen ventanas ridículas de fábrica. LM Studio arranca en 2.000-4.000 tokens, Ollama baja a 4.000 en tarjetas de menos de 24 GB (cuando su propia documentación pide 64.000 para agentes) y llama.cpp anda por lo mismo. Con eso, cualquier agente que lea archivos se ahoga.
Lo que a él le funcionó:
• Subir la ventana de contexto (se fija al cargar el modelo; ojo con tu VRAM).
• Cuantizar la caché KV a Q8_0 (K y V) con Flash Attention activado.
• Dejar el modo «thinking» desactivado: los tokens de razonamiento también gastan contexto.
• Elegir bien el cuantizado (Q4_K_M suele ser el equilibrio) y dejar ~1,5 GB de margen libre.
• Ajustar el offload a GPU hasta dar con el punto dulce.
Resultado: el agente completó las seis fases sin un solo error de contexto. Sigue tardando unos 14 minutos en un equipo modesto, pero funciona.
👉 ¿Tienes agente local montado? ¿Qué ajustes usas tú?
📰 Vía @XDA Developers: https://www.xda-developers.com/stopped-my-local-llm-agent-from-running-out-of-context/
#IA #LLM #IAenLocal #Tips #JaviTech