 JaviTech
Ya no necesitas una GPU dedicada para ejecutar LLM en local
12 de octubre de 2026 · IA local y LLM
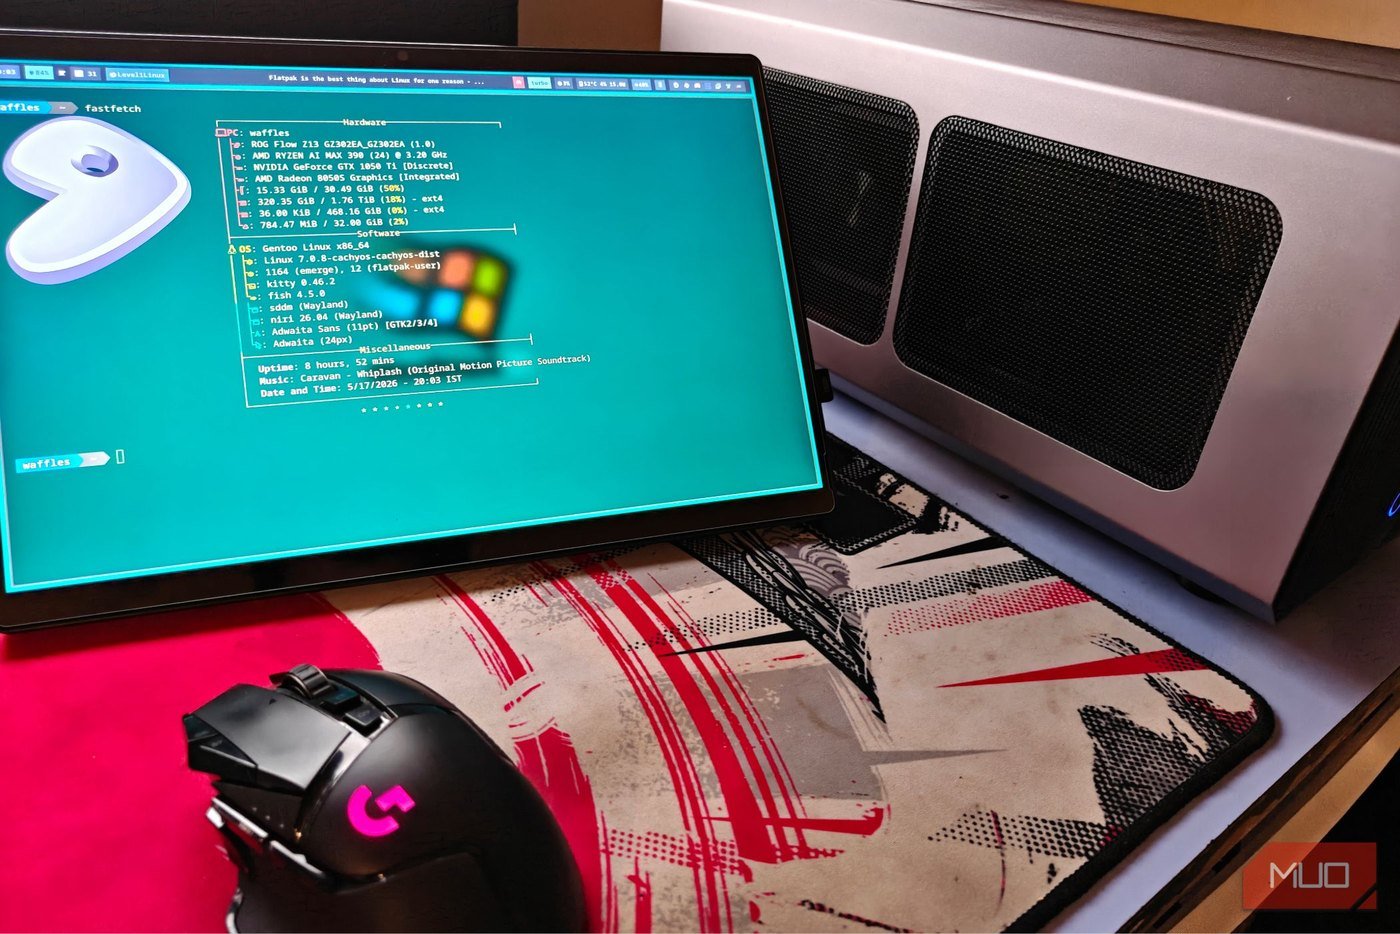
🛠️ ¿Pensabas que para trastear con modelos de lenguaje en tu equipo hacía falta comprarse una gráfica dedicada? MakeUseOf lo ha puesto a prueba y la respuesta es: ni de lejos.
Han montado un banco de pruebas con tres equipos tirando solo de gráfica integrada: un ASUS ROG Flow Z13 (Ryzen AI Max 390, 32 GB), un Lenovo Legion Go (Ryzen Z1 Extreme, 16 GB) y hasta el humilde Vega 7 de un Ryzen 5 5600G. Resultado:
• El AI Max 390 se sale: rinde a la altura de GPUs de escritorio.
• El Z1 Extreme del Legion Go aguanta con dignidad, en torno a 44 tok/s.
• El Vega 7 del 5600G sí puede, pero a 17,5 tok/s y con trucos: backend Vulkan (no hay ROCm), 16 GB de VRAM asignados desde la BIOS y configurar Ollama a mano.
Moraleja: para cacharrear con IA local no hace falta gastarse un dineral, aunque el silicio bueno sigue costando lo suyo. 🤓
📰 Vía @MakeUseOf: https://www.makeuseof.com/you-dont-need-a-discrete-gpu-to-run-local-llms-anymore/
#Tips #IA #Hardware #LLM #Productividad